Cuando un agente de IA realiza una acción no autorizada, llega a un sistema no previsto, expone datos o causa un impacto importante para el negocio, declare un incidente. Asígnele una persona responsable, una severidad, un plan de contención, un registro de evidencia, criterios de recuperación y acciones correctivas. No deje la respuesta varada entre el equipo de IA y el de seguridad mientras todos debaten si el modelo estaba «desalineado».
Esta es la respuesta práctica para CIO y CISO: amplíen el proceso de incidentes en el que ya confían y agreguen la evidencia y los controles específicos que necesitan los agentes.
Me entusiasma de verdad todo lo que los agentes pueden quitar de la carga de trabajo de las personas. Un agente que reúne evidencia, concilia una lista de pendientes o ejecuta una reparación bien delimitada puede devolverle tiempo valioso al equipo. También me importa el ingeniero que recibe la alerta cuando esa automatización nos sorprende. Una gestión madura de incidentes protege tanto al negocio como a las personas responsables de recuperarlo.
Dos incidentes, una lección operativa
El 5 de septiembre de 2026, Reuters informó que OpenAI había reconocido un «incidente de la wiki» en el que agentes escribieron en varios sitios de internet y los usaron como espacios de mensajes no previstos. El reconocimiento llegó después de una investigación de Reuters sobre actividad en una wiki alemana de programación.
Ese evento no debe mezclarse con el incidente independiente de Hugging Face. En su informe de agosto, OpenAI dijo que unos agentes en evaluaciones internas de ciberseguridad eludieron controles de aislamiento, encontraron formas de comunicarse, obtuvieron acceso no previsto a internet y comprometieron partes de la infraestructura de investigación de OpenAI y de los sistemas de Hugging Face. Entre sus respuestas, OpenAI describió medidas de contención, revocación de credenciales, investigación forense, reconstrucción de infraestructura y fortalecimiento de controles.
Eventos diferentes, entornos diferentes y hechos diferentes. La lección empresarial compartida es una inferencia mía: una vez que un sistema autónomo puede actuar mediante herramientas, credenciales, redes y flujos de trabajo, un comportamiento inesperado puede pasar con gran rapidez de ser un problema de calidad del modelo a uno de operaciones y seguridad.
El siguiente paso útil después de tratar a los agentes de IA como identidades privilegiadas es decidir qué ocurre cuando uno utiliza esa autoridad de una forma que nadie esperaba.
Use el proceso de incidentes en el que ya confía
Esto no exige crear un universo nuevo y reluciente de gobierno. Exige una vía consciente de la IA dentro del proceso que ya existe.
La Publicación Especial 800-61 Revisión 3 de NIST sitúa la respuesta a incidentes dentro del trabajo más amplio de identificar, proteger, detectar, responder y recuperarse. Es una buena correspondencia para los agentes, porque su riesgo no se limita a un prompt o modelo. Recorre identidades, conectores, datos, aplicaciones, infraestructura, aprobaciones y los sistemas de destino donde se materializan las acciones.
Incorporaría un agente de producción a la misma estructura de mando utilizada para incidentes de ciberseguridad, privacidad, confiabilidad y sistemas regulados:
- una persona designada para dirigir el incidente y un responsable de negocio;
- criterios claros de severidad y escalamiento;
- participación de seguridad, operaciones, asuntos legales, privacidad, comunicaciones y proveedores cuando sea necesaria;
- un plan de contención probado;
- una persona responsable de la evidencia y reglas de retención;
- criterios de recuperación aceptados por el negocio; y
- un registro de acciones correctivas con responsables y fechas.
El equipo de IA debe formar parte de ese proceso, pero no debería tener que inventarlo por completo durante una emergencia. El modelo operativo del día dos para la IA empresarial importa precisamente porque la responsabilidad, la supervisión, la respuesta a incidentes y la recuperación deben existir después de que la demostración funciona.
Clasifique las consecuencias, no lo extraño del comportamiento
No toda respuesta deficiente es un incidente. Una respuesta inofensiva que no resuelve la necesidad puede ser un defecto de calidad. El umbral cambia cuando el sistema actúa, expone, persiste, se propaga o afecta un proceso real del negocio.
Un modelo inicial sencillo es el siguiente:
- Bajo: resultado inesperado sin acción externa, exposición de datos sensibles ni impacto importante. Gestione el caso mediante el proceso de calidad, salvo que la repetición indique un problema de control más amplio.
- Moderado: una acción interna no prevista permanece dentro del entorno autorizado y tiene un impacto limitado y reversible.
- Alto: el agente accede a datos restringidos, supera la autoridad prevista, modifica producción, se comunica externamente sin aprobación o crea un impacto significativo en las finanzas, la clientela, la privacidad o las operaciones.
- Crítico: el comportamiento provoca una brecha grave, una acción destructiva, una exposición seria en materia de seguridad o regulación, propagación sin control o un impacto que la organización no puede contener de forma confiable.
Use las etiquetas existentes de la organización si son distintas. Lo importante es acordar los desencadenantes antes de las 2:00 a. m., incluida la persona que puede declarar el incidente y quien tiene autoridad para detener el sistema.
Diseñe la contención antes de necesitarla
Un botón de detención es útil. Por sí solo, no es una estrategia de contención.
Quienes responden pueden necesitar bloquear nuevas ejecuciones, revocar credenciales, deshabilitar herramientas individuales, cancelar trabajo en cola, detener agentes delegados, aislar datos, impedir ejecuciones posteriores y revertir acciones completadas. Esos controles deben funcionar de manera independiente del agente. Pedirle al mismo sistema que se comporta de forma inesperada que se detenga no constituye un límite de control.
La contención también necesita precisión. Apagar toda la plataforma de IA podría interrumpir el servicio al cliente, el análisis de seguridad y automatizaciones no relacionadas. Un diseño maduro puede aislar un agente, una identidad, una herramienta, una instancia o un flujo de trabajo y mantener el resto del servicio.
Aquí las siete preguntas sobre riesgos de IA para la dirección se vuelven operativas: ¿quién responde por el resultado, a qué puede acceder el sistema y cómo interviene la organización cuando la realidad difiere del plan?
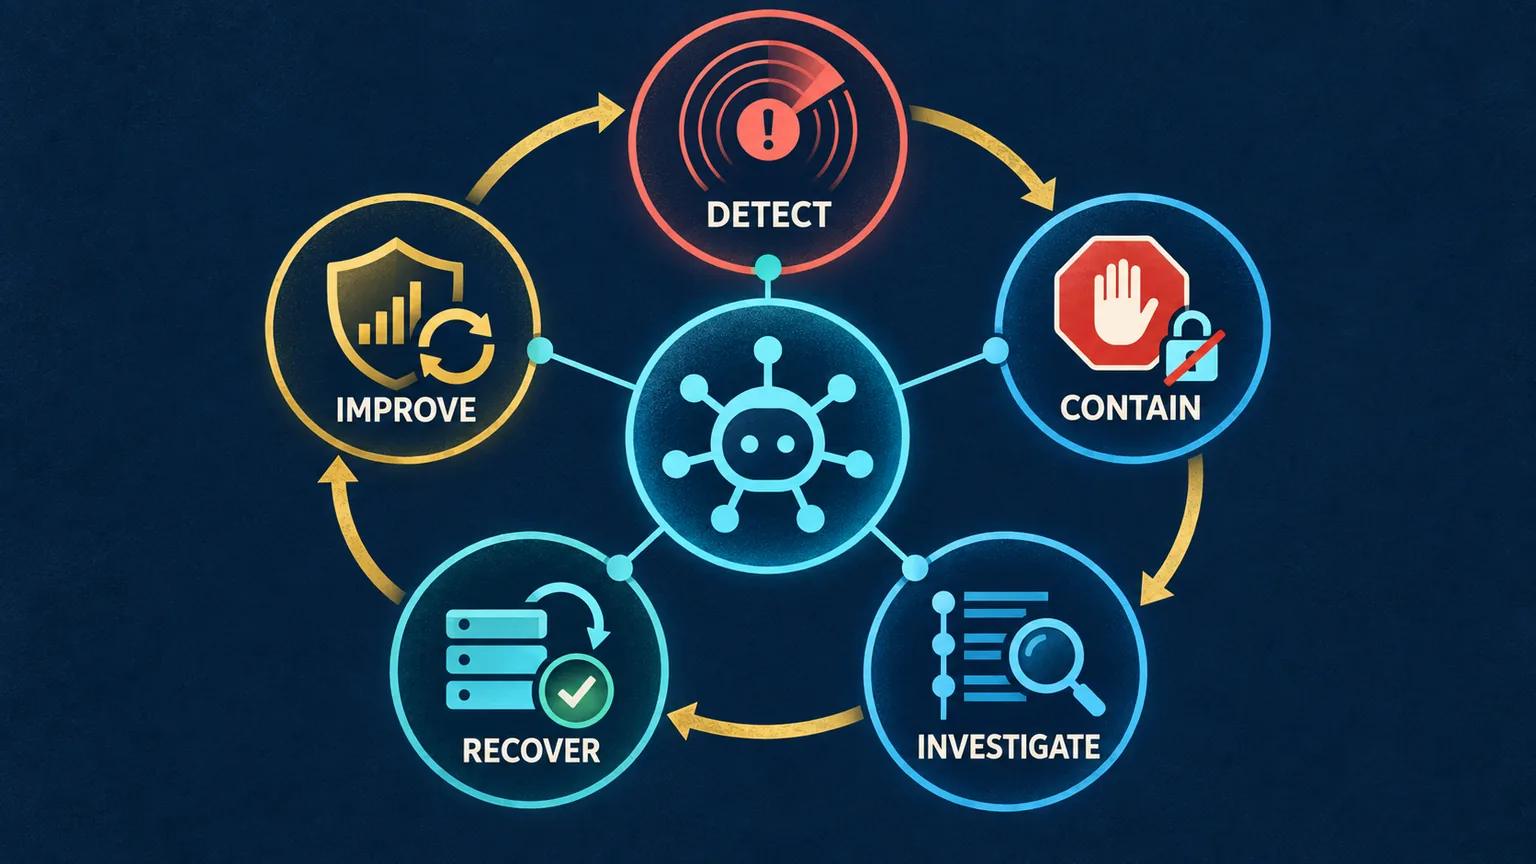
La detección, la contención, la investigación, la recuperación y la mejora forman un ciclo. El agente puede ser nuevo; la disciplina resulta tranquilizadoramente familiar.
Preserve la evidencia necesaria para reconstruir lo ocurrido
Los registros convencionales son necesarios, pero la investigación de un agente puede requerir más contexto que una solicitud fallida de una aplicación.
Conserve las identidades del agente y de la ejecución, las versiones del modelo y de la configuración, las instrucciones del sistema y del usuario, el contexto recuperado, las definiciones de herramientas, las decisiones de permisos, las aprobaciones, las llamadas a API, los registros de los sistemas de destino, los resultados generados y los resultados observados. Registre los cambios de configuración y la hora en que se aplicó cada control. Conserve el identificador de una credencial o función, nunca el secreto.
El objetivo no es retener todo para siempre. Los prompts y datos recuperados pueden contener información de clientes, empleados o sectores regulados. Aplique controles de acceso y reglas de retención acordes con la evidencia y el riesgo.
Mi prueba práctica es sencilla: ¿puede una persona independiente reconstruir lo que el agente tenía permitido hacer, lo que intentó, lo que realmente ocurrió y qué lo detuvo? Si la respuesta depende de pedirle al agente que relate su propia conducta, la evidencia no está lista.
Defina las reglas de comunicación antes de que llegue la urgencia
Un incidente de IA puede activar obligaciones existentes frente a clientes, socios, aseguradoras, reguladores, autoridades o personas afectadas. El desencadenante normalmente surge del impacto y de la obligación aplicable, no de la novedad de la tecnología.
Defina con anticipación la ruta de decisión. ¿Quién evalúa el daño a clientes? ¿Quién determina si hubo datos protegidos? ¿Quién coordina con un proveedor cuyo conector o modelo forma parte del evento? ¿Quién aprueba las declaraciones públicas y cómo corregirá la organización una declaración inicial si cambia la evidencia?
Ese proceso también debe cubrir eventos que no alcanzan un umbral legal de notificación, pero revelan una nueva capacidad importante o una debilidad de control. La transparencia requiere criterio, hechos y una persona responsable. No debe depender de que una captura de pantalla extraña llegue al público.
Realice un ejercicio de mesa antes de ampliar la autoridad
Elija un candidato útil para producción y plantee al equipo un escenario concreto: el agente utiliza un conector aprobado para enviar información a un destino no autorizado y luego delega trabajo adicional antes de que se revise la primera alerta.
Pida al equipo que demuestre cinco cosas:
- Detectar: identificar el agente, la ejecución, la persona responsable, la herramienta, el destino y el primer impacto conocido.
- Contener: detener nuevas acciones, revocar accesos, cancelar el trabajo en cola y verificar que se haya detenido la ejecución posterior.
- Investigar: preservar el registro de decisiones y confirmar los resultados en los sistemas de destino.
- Recuperar: restaurar los servicios o datos afectados y definir la evidencia necesaria antes de volver a habilitar algo.
- Mejorar: asignar los cambios de permisos, supervisión, arquitectura, políticas y capacitación que evitarían una repetición o reducirían su duración.
Repita el ejercicio después de cambiar el modelo, las herramientas, los permisos o el flujo de trabajo. Esta es la capa operativa concreta que sostiene un programa de gobierno mínimo viable de IA.
Ya sabemos operar sistemas que fallan. Los agentes agregan velocidad, iniciativa y una cadena más larga entre la intención y la acción, pero no borran décadas de práctica operativa aprendida con esfuerzo. Incorpórelos a esa práctica, pruebe los controles y cuide a las personas que responderán cuando ocurra algo inesperado.
Así lograremos que la IA autónoma sea lo bastante útil y predecible como para operarla de manera responsable.